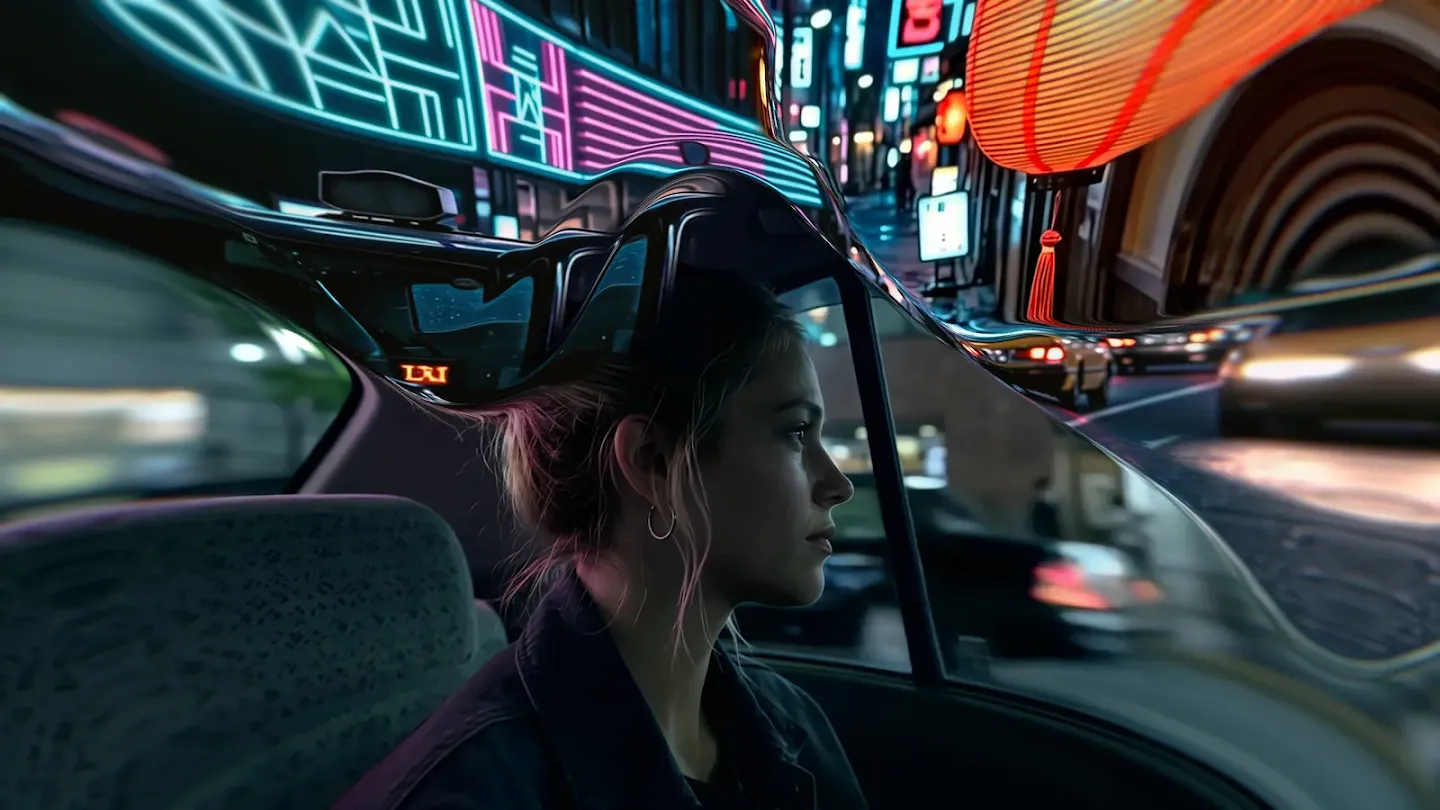
Scrivere una scena, entrarci e cambiarla mentre accade. È la promessa di Genie 4, il modello presentato da Google DeepMind il 27 ottobre: un sistema che genera ambienti interattivi, con suoni e personaggi capaci di dialogare. Google ha avviato una sperimentazione con un gruppo ristretto di tester; l’accesso attraverso Project Genie, Gemini API e AI Studio arriverà successivamente. Ecco che cosa fa, a cosa potrebbe servire e chi lavora a tecnologie concorrenti.
Che cos’è un modello del mondo
Un world model è un’intelligenza artificiale che cerca di rappresentare un ambiente e di simularne l’evoluzione in risposta alle azioni. In Genie 4 l’utente può esplorare la scena e intervenire mentre viene generata. Il risultato è un’esperienza nella quale ciò che vediamo cambia anche in funzione dei nostri comandi. Google collega questa ricerca alla costruzione di sistemi capaci di comprendere il mondo e agirvi. È un obiettivo di ricerca: la qualità delle immagini, da sola, non dimostra una comprensione affidabile della realtà fisica.
Che cosa fa: immagini, suoni e dialoghi in tempo reale
Si può cambiare il tempo atmosferico, spostare la camera, aggiungere persone e oggetti. La novità è l’audio generato insieme all’ambiente: rumori, musica e conversazioni che si adattano agli eventi. I modelli Gemini contribuiscono a mantenere la continuità della simulazione. Nell’architettura descritta da DeepMind, Gemini 3.8 Flash osserva le immagini, scompone gli obiettivi in passaggi e controlla il loro avanzamento. Genie produce la rappresentazione visiva e sonora di ciò che accade.
A cosa serve: provare una scena prima di realizzarla
Gli impieghi in sperimentazione comprendono la preparazione di riprese cinematografiche, i prototipi di videogiochi e gli ambienti per robot e agenti artificiali. Un regista può esplorare inquadrature e azioni; uno sviluppatore verificare un’idea prima di costruirla in un motore grafico. Google cita anche esperimenti giornalistici ed educativi, come l’esplorazione di ambienti ricavati da fotografie d’archivio. Sono applicazioni preliminari: una ricostruzione generata richiede verifiche ulteriori prima di essere usata come rappresentazione documentale.
Quali sono i limiti: il realismo non garantisce l’accuratezza
Le sessioni continue durano pochi minuti. Nel tempo, oggetti e dettagli possono cambiare o perdere coerenza, soprattutto dopo interventi complessi. Restano problemi nelle interazioni fisiche, nell’audio, nella leggibilità delle scritte e nella riproduzione dei luoghi reali. Perciò un ambiente convincente sullo schermo non equivale a un simulatore scientificamente validato. Per impieghi come robotica o ingegneria occorre misurare quanto le conseguenze generate corrispondano a quelle reali.
Chi sono i concorrenti
Il confronto coinvolge sistemi con obiettivi diversi. Runway GWM-1 è tra i più vicini per impostazione: comprende varianti dedicate ad ambienti esplorabili, personaggi conversazionali e manipolazione robotica. La sovrapposizione con Genie riguarda sia l’interazione sia la simulazione. Marble di World Labs punta sulla costruzione di mondi tridimensionali persistenti, modificabili ed esportabili. La differenza riguarda il risultato: un ambiente 3D utilizzabile in altri strumenti, con particolare attenzione alla struttura spaziale. Nvidia Cosmos compete soprattutto sul versante industriale: modelli del mondo, generazione di dati sintetici e strumenti per sviluppare robot, veicoli autonomi e altri sistemi di intelligenza artificiale fisica. Muse di Microsoft, infine, è un progetto più circoscritto al videogioco: genera immagini di gioco, azioni del controller o entrambe, per esplorare possibilità creative. Sono concorrenti per parti del problema; le fonti consultate non offrono un confronto comune sufficiente a stabilire quale sistema sia complessivamente migliore.
Per approfondire.
Gemini 4 Argon, primo in 12 test su 18: cosa convince e cosa manca al nuovo modello di Google
Cosa sappiamo su Gemini 4 Argon?
Come è fatto Gemini 3.8 Flash?
Google Pics è ora disponibile. Ecco cosa sa fare
Gemini 3.7 Flash spiegato in cinque punti. Spoiler: Google sempre di più è piattaforma agentica
Gemini Robotics 2, in cinque punti quello che c’è da sapere
Come funziona Gemini Omni? La nostra prova in cinque video
Google I/O: In cinque annunci e dieci video tutto quello che è successo
Nano banana 2 vs ChatGpt Image 2.0: la sfida in cinque prompt (più uno)
Search Live è disponibile in Italia, cosa cambia in cinque punti
Google Earth diventa il “sistema operativo” del mondo: 5 punti per capire la svolta
Cosa sono Ask Maps e Immersive Navigation?
Tutto quello che c’è da sapere su Gemini 3.1 Flash-Lite
Tutto quello che c’è da sapere su Gemini 3.1 Pro
Ecco Lyria 3: Google con Gemini porta la musica generativa negli smartphone
Gemini 3 Deep Think si aggiorna: più ragionamento, più scienza, accesso selettivo in cinque punti
Google collega Gemini con foto e mail per creare un assistente davvero personale
Tutto quello che c’è da sapere su Nano Banana Pro in cinque punti
ChatGPT dichiara codice rosso: nasce GPT-5.2, anche per rispondere a Gemini 3
Buon compleanno ChatGPT. Tre candeline e tre grafici
Tono, personalizzazione e “umanità”: come è cambiato ChatGPT?
Nuove regole per ChatGPT: cosa cambia davvero per gli utenti in cinque punti
Tutto quello che c’è da sapere su Atlas il nuovo browser potenziato con l’Ai di OpenAi
Cosa c’è da sapere sul Dev Day 2025 di OpenAI
I cameo, il deepfake consensuale e quello che dobbiamo sapere dell’app Sora di OpenAI
Nasce ChatGPT Pulse, il “buongiorno” firmato OpenAI. In cinque punti
Perché tutti parlano di Codex di OpenAi?
ChatGpt-5, breve guida al prompting. Cosa c’è da sapere?
Tre prompt per mettere alla prova Gpt 5. Il confronto co ChatGpt 4o, Gemini e Claude.
GPT-5 è tra noi. Cosa cambia? In cinque punti, quattro video e qualche grafico
Aspettando ChatGpt5 OpenAI lancia modelli “open-weight” per fronteggiare DeepSeek e Meta
ChatGpt, OpenAI lancia la modalità studio per studenti
Arriva ChatGpt agent anche in Europa. Cosa sa fare? In cinque punti
Cosa è OpenAi Codex? #DatavizAndTools
Come funziona Operator l’Ai agent di OpenAi?
Cos’è Operator e come funziona l’Ai agent di OpenAi?
Tra qualche mese uscirà il prossimo Gpt-5 che integrerà o3 il modello di ragionamento più avanzato
ChatGpt su WhatsApp ascolta i vocali e legge le immagini #DatavizAndTools
Sam Altman dalla “parte sbagliata della storia”
OpenAi aggiorna Canvas. Ecco cosa cambia con o1
Come funziona Operator di OpenAi? #DatavizAndTools
ChatGpt Task è una to-do-list per le tue attività quotidiane
Come funziona Canvas la nuova interfaccia per ChatGpt? #DatavizAndTools
Ecco come funziona o1, il modello di OpenAi che “pensa” prima di rispondere
Disponibile ChatGpt per Windows. Ecco cosa cambia #DatavizAndTools
L’informazione, i giornali, i viaggi e il senso della vita. La prova di SearchGpt
SearchGpt sta arrivando. OpenAi sfida Google sui motori di ricerca. Ecco cosa sappiamo finora
Che fine ha fatto SearchGpt, il motore di ricerca di OpenAi?
Cosa è AI Overview? Ecco come sta cambiando il motore di ricerca di Google con Gemini
Cosa è WildChat? Più di un milione di prompt (e risposte) per allenare il vostro chatbot
Come si scrive un prompt per Midjourney?
L’Ai Gen si è convertita all’ideologia “woke”? #PromptAnalysis
Quali caratteristiche deve avere un cantante per vincere Sanremo? Risponde Gpt4