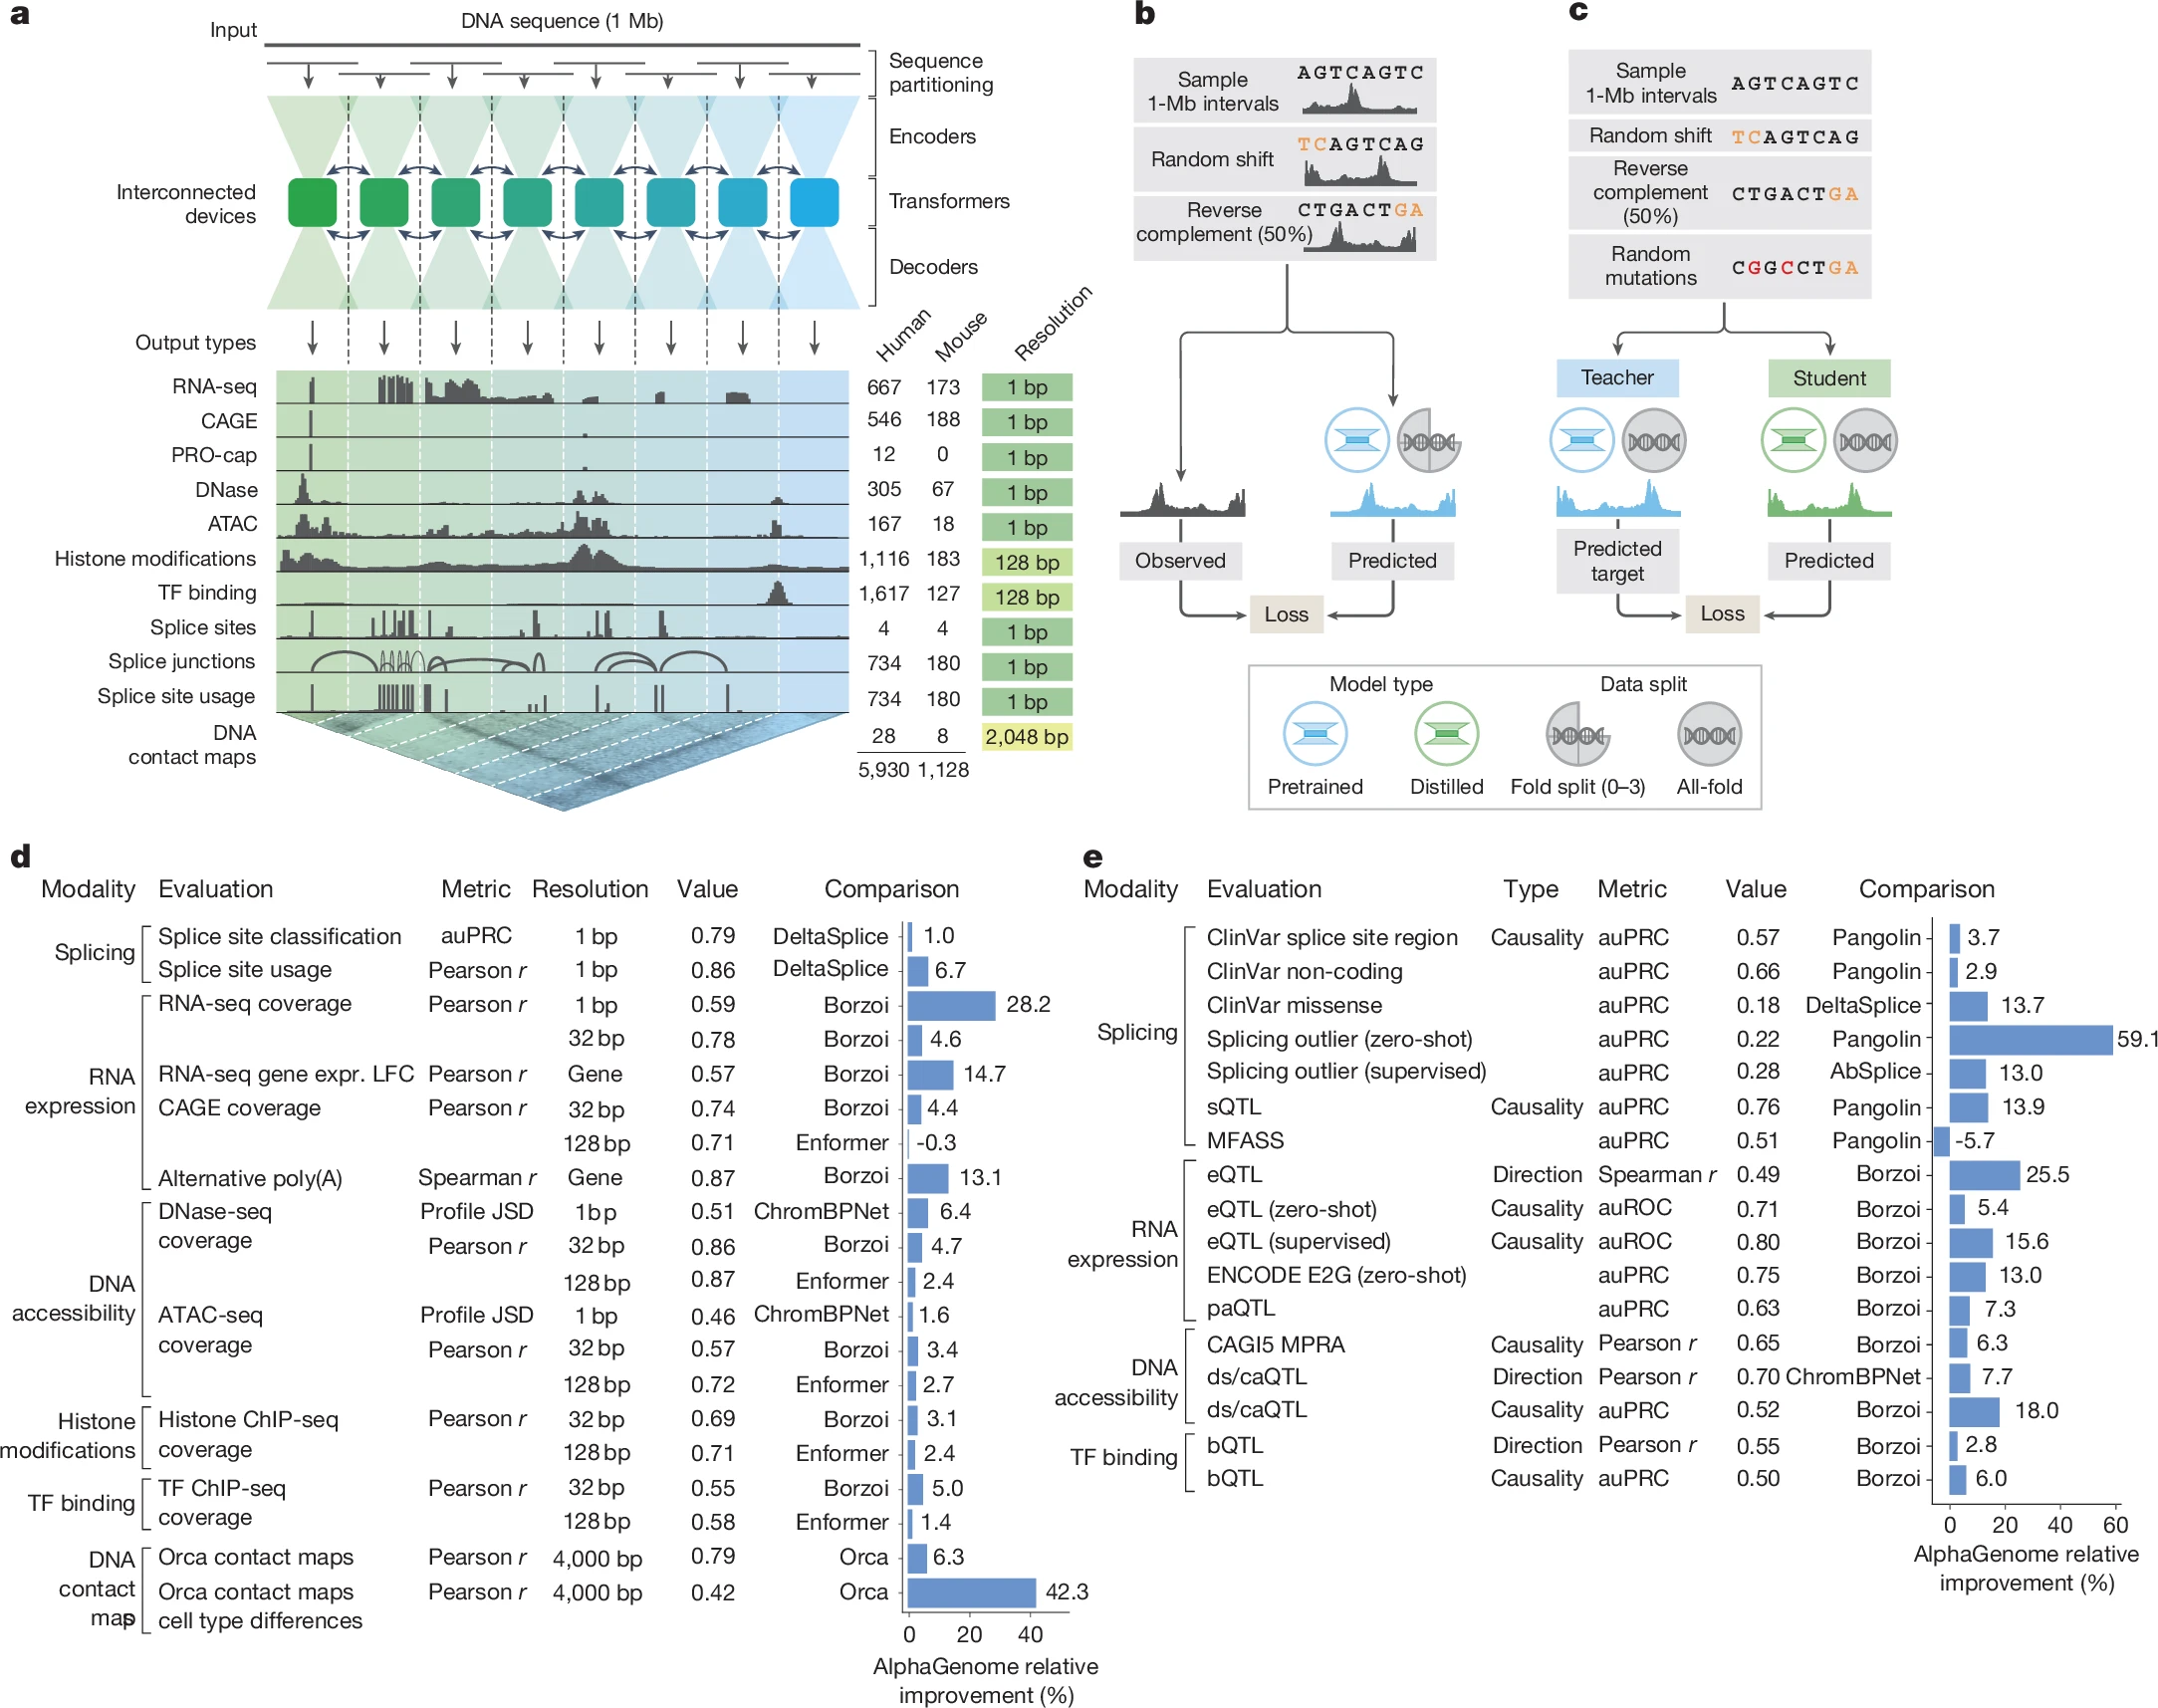
Un anno fa, a giugno Google Deepmind aveva annunciato il rilascio gratuito di AlphaGenome, un algoritmo di IA in grado di generare delle previsioni di come singole varianti o mutazioni nelle sequenze di DNA umano incidano su un’ampia gamma di processi biologici che regolano i geni. Ciò è stato reso possibile, tra gli altri fattori, dai progressi tecnici che hanno consentito al modello di elaborare lunghe sequenze di DNA e di fornire previsioni ad alta risoluzione. A gennaio 2026 sono usciti il paper che ne descrive nel dettaglio i meccanismi sulla rivista Nature e il modello su GitHub.
Obiettivo: supportare gli scienziati a comprendere meglio la funzione del genoma e la biologia delle malattie e, in ultima analisi, promuovono nuove scoperte biologiche e lo sviluppo di nuovi trattamenti.
A un anno di distanza l’8 settembre 2026 l’azienda ha lanciato ufficialmente AlphaGenome Atlas, la banca dati vera e propria che riporta le previsioni sui possibili effetti di nove miliardi di singole varianti presenti nel genoma umano utilizzando appunto le previsioni generate dal modello di IA AlphaGenome, rilasciato l’anno scorso. L’atlante è disponibile gratuitamente per uso non commerciale.
Perché un atlante del genoma umano
Solo il 2% dei suoi tre miliardi di lettere codifica proteine, mentre il resto è incredibilmente difficile da decifrare. Uno dei tipi più comuni di variazione nel genoma umano è costituito da modifiche ai singoli nucleotidi del DNA, o lettere. Queste sostituzioni contribuiscono alle differenze tra le persone in fattori quali il rischio di malattia; alcune rare modifiche di una singola lettera possono causare direttamente patologie. Un “atlante” del genoma umano generato dall’intelligenza artificiale, mira a guidare gli scienziati attraverso il nostro codice biologico. Secondo i ricercatori, lo strumento potrebbe aiutare a stabilire collegamenti tra varianti genetiche e malattie rare e inspiegabili, oltre a svelare meccanismi nascosti alla base di patologie comuni e tratti biologici. Potrebbe persino rivelare alcune delle regole con cui le sequenze di DNA controllano l’attività genica.
Per capire le dimensioni di questo atlante
Un petabyte è una quantità colossale di dati: equivale a 1 milione di gigabyte, ovvero lo spazio necessario per memorizzare circa 500 miliardi di pagine di testo standard o più di 4.000 ore di video in altissima definizione (4K). Di fronte a questa mole di informazioni, 9 miliardi di variazioni possono sembrare poche, ma nel contesto del DNA umano sono un numero straordinariamente vasto.
Il DNA di una singola persona è come un libro di istruzioni stampato in due copie identiche nelle funzioni, ma con piccole varianti: una ereditata dalla madre e una dal padre. Ciascuna di queste due copie è lunga circa 3 miliardi di lettere. Di conseguenza, se contiamo fisicamente tutte le lettere presenti in una singola cellula, il totale è di circa 6 miliardi. Gli scienziati e l’intelligenza artificiale usano come mappa di riferimento una sola copia da 3 miliardi per comodità; ecco perché moltiplicando quei 3 miliardi di posizioni per le 3 lettere alternative possibili si arriva a calcolare i 9 miliardi di mutazioni complessive dell’AlphaGenome Atlas.
Mappare 9 miliardi di mutazioni significa aver calcolato non solo la sequenza base, ma l’impatto di ogni singola alterazione teoricamente possibile di quelle lettere in ogni punto strategico del nostro codice genetico. Per un essere umano, analizzare e catalogare manualmente una simile quantità di combinazioni avrebbe richiesto secoli di studi in laboratorio; l’intelligenza artificiale è riuscita a prevederle e a racchiuderle tutte in un unico, immenso archivio digitale.
Qualche esempio?
In questi mesi, stando a quanto ha dichiarato Dhavi Hariharan, product manager di DeepMind, a Nature, circa 9.000 ricercatori hanno avuto accesso alle previsioni del modello tramite un’interfaccia di programmazione delle applicazioni (API). Il problema è che questa operazione richiede la scrittura di codice software, un ostacolo per alcuni biologi.
E infatti alla fine del comunicato stampa di Google Deepmind si leggono i ringrazimenti a chi ha collaborato alle ricerche e i nomi sono importanti: University of Exeter, Broad Institute, Boston Children’s Hospital, Stowers Institute for Medical Research, Harvard University, Memorial Sloan Kettering Cancer Center, Center for Genomic Medicine at Massachusetts General Hospital, and the University of Kansas Medical Center.
I ricercatori di Exeter ad esempio, hanno applicato AlphaGenome Atlas ai dati dell’intero genoma di oltre 54.000 partecipanti alla UK Biobank, rendendo così più facilmente identificabili segnali genetici altrimenti difficili da individuare. Si tratta – ha spiegato Gareth Hawkes, coordinatore del progetto – di ridurre le dimensioni del pagliaio per aumentare la probabilità di trovare l’ago”. Raggruppando le varianti rare in base agli effetti molecolari previsti, il team di Hawkes ha individuato il 22% in più di associazioni genetiche non codificanti, che altrimenti sarebbero rimaste nascoste nel “rumore” statistico. Ciò ha permesso di identificare specifiche varianti regolatorie che influenzano i livelli di proteine fondamentali circolanti nell’organismo umano, tra cui PLA2G7 (associata all’invecchiamento) ed EGLN1 (un sensore vitale dell’ossigeno cellulare).
E ancora: Laura Covill, Anne O’Donnell-Luria e i loro colleghi del Broad Institute di Cambridge, Massachusetts, centro di ricerca congiunto fra il MIT e l’università di Harvard, in collaborazione con il Consorzio GREGoR, che sta per Genomics Research to Elucidate the Genetics of Rare diseases, in italiano “Ricerca genomica per chiarire la genetica delle malattie rare”, hanno usato il punteggio AVI per cercare gli “aghi nel pagliaio” relativi alle malattie rare irrisolte. Hanno così scoperto una variante che colpisce un gene chiamato DNM1, fortemente legato alla rara sindrome dell’encefalopatia epilettica. Il punteggio AVI (AlphaGenome Variant Impact) integra le previsioni di AlphaGenome sulla regolazione genica con le stime di AlphaMissense – modello di intelligenza artificiale sviluppato sempre da Google DeepMind per prevedere se una singola modifica genetica in una proteina umana è dannosa o benigna – sulla patogenicità proteica. Un punteggio AVI pari a 10 colloca una variante nel 10% superiore per impatto biologico previsto; un valore di 30 la posiziona invece nel primo 0,1%. Il punteggio è inoltre scomponibile: i ricercatori possono individuare esattamente quali processi — come lo splicing, l’espressione genica o l’alterazione proteica — determinino il valore assegnato alla variante, ottenendo così informazioni sul meccanismo d’azione oltre che sulla classificazione.
Per approfondire
Ai, la nuova età dell’oro della ricerca scientifica potrebbe costarci molto
A Roma 12 bambini su 100 non vanno alla scuola materna, a Milano 8 su 100. Perché?